在當(dāng)今信息爆炸的時(shí)代,數(shù)據(jù)已成為驅(qū)動(dòng)社會(huì)進(jìn)步和企業(yè)決策的核心要素。面對(duì)海量、多樣、高速產(chǎn)生的數(shù)據(jù),傳統(tǒng)的數(shù)據(jù)處理技術(shù)已難以應(yīng)對(duì),大數(shù)據(jù)技術(shù)應(yīng)運(yùn)而生。在眾多大數(shù)據(jù)處理框架中,Hadoop以其高可靠性、高擴(kuò)展性和低成本等優(yōu)勢(shì),成為了事實(shí)上的行業(yè)標(biāo)準(zhǔn)。本文將深入探討Hadoop數(shù)據(jù)處理的核心概念、技術(shù)架構(gòu)、典型流程及其應(yīng)用價(jià)值。
一、Hadoop 概述:分布式系統(tǒng)基石
Hadoop是一個(gè)開(kāi)源的分布式計(jì)算框架,由Apache基金會(huì)維護(hù)。其核心設(shè)計(jì)靈感來(lái)源于Google的MapReduce編程模型和Google File System(GFS)。Hadoop旨在將海量數(shù)據(jù)集的存儲(chǔ)和處理任務(wù),分散到成百上千臺(tái)廉價(jià)的商用服務(wù)器集群上,從而實(shí)現(xiàn)并行、高效的計(jì)算。其核心優(yōu)勢(shì)在于:
- 高可靠性:數(shù)據(jù)在集群中被多副本存儲(chǔ),即使部分硬件發(fā)生故障,系統(tǒng)也能自動(dòng)恢復(fù),保證數(shù)據(jù)不丟失。
- 高擴(kuò)展性:可以通過(guò)簡(jiǎn)單地增加節(jié)點(diǎn)來(lái)線性擴(kuò)展集群的存儲(chǔ)和計(jì)算能力。
- 高容錯(cuò)性:任務(wù)執(zhí)行失敗后,能自動(dòng)重新調(diào)度到其他節(jié)點(diǎn)完成。
- 低成本:構(gòu)建在廉價(jià)的商用硬件之上,降低了大數(shù)據(jù)處理的入門(mén)門(mén)檻。
二、Hadoop 核心組件:一個(gè)協(xié)同工作的生態(tài)系統(tǒng)
Hadoop生態(tài)系統(tǒng)主要由兩大核心組件構(gòu)成,它們共同支撐起數(shù)據(jù)處理的全流程:
- Hadoop Distributed File System (HDFS):分布式文件系統(tǒng)。
- 職責(zé):負(fù)責(zé)數(shù)據(jù)的存儲(chǔ)。它將大文件(如TB、PB級(jí))切割成固定大小的數(shù)據(jù)塊(默認(rèn)為128MB或256MB),并將這些數(shù)據(jù)塊及其冗余副本分布式地存儲(chǔ)在整個(gè)集群的多個(gè)節(jié)點(diǎn)上。
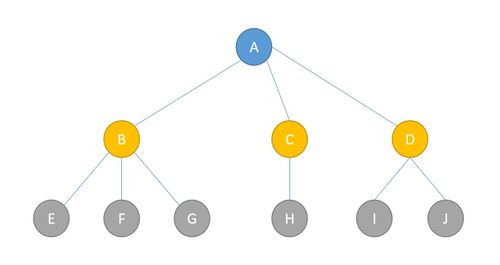
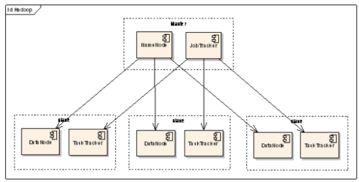
- 架構(gòu):采用主從(Master/Slave)架構(gòu)。
- NameNode:主節(jié)點(diǎn),負(fù)責(zé)管理文件系統(tǒng)的命名空間(如目錄樹(shù)、文件元數(shù)據(jù))以及數(shù)據(jù)塊到DataNode的映射關(guān)系。它是整個(gè)HDFS的大腦。
- DataNode:從節(jié)點(diǎn),負(fù)責(zé)存儲(chǔ)實(shí)際的數(shù)據(jù)塊,并執(zhí)行數(shù)據(jù)塊的讀寫(xiě)操作。
- Hadoop MapReduce:分布式計(jì)算框架。
- 職責(zé):負(fù)責(zé)數(shù)據(jù)的計(jì)算。它將計(jì)算任務(wù)抽象為兩個(gè)主要階段:Map(映射)和Reduce(歸約)。
- 編程模型:
- Map階段:將輸入數(shù)據(jù)分割成獨(dú)立的片段,由多個(gè)Map任務(wù)并行處理,輸出一系列中間鍵值對(duì)(key-value pairs)。其核心思想是“分而治之”。
- Shuffle & Sort階段:系統(tǒng)自動(dòng)將Map輸出的中間結(jié)果,按照Key進(jìn)行排序、分區(qū),并傳輸?shù)綄?duì)應(yīng)的Reduce節(jié)點(diǎn)。這是連接Map和Reduce的關(guān)鍵環(huán)節(jié)。
- Reduce階段:接收屬于同一個(gè)Key的所有中間值,進(jìn)行聚合、匯總或其他計(jì)算,最終產(chǎn)生輸出結(jié)果。
- 架構(gòu):同樣采用主從架構(gòu)。
- ResourceManager:主節(jié)點(diǎn),負(fù)責(zé)整個(gè)集群的資源管理和作業(yè)調(diào)度。
- NodeManager:從節(jié)點(diǎn),負(fù)責(zé)管理單個(gè)節(jié)點(diǎn)上的資源和任務(wù)執(zhí)行。
三、Hadoop 數(shù)據(jù)處理典型流程
一個(gè)完整的Hadoop數(shù)據(jù)處理作業(yè)通常遵循以下步驟:
- 數(shù)據(jù)輸入:原始數(shù)據(jù)(如日志文件、數(shù)據(jù)庫(kù)導(dǎo)出文件)被上傳或?qū)懭際DFS。HDFS會(huì)自動(dòng)將其分塊并分布式存儲(chǔ)。
- 作業(yè)提交:用戶(hù)編寫(xiě)MapReduce程序(Java、Python等),定義好Map和Reduce函數(shù)邏輯,然后將作業(yè)提交給ResourceManager。
- 任務(wù)調(diào)度與執(zhí)行:ResourceManager根據(jù)數(shù)據(jù)本地性(將計(jì)算任務(wù)調(diào)度到存儲(chǔ)有所需數(shù)據(jù)塊的節(jié)點(diǎn)上,以減少網(wǎng)絡(luò)傳輸)原則,在集群的NodeManager上啟動(dòng)Map任務(wù)。每個(gè)Map任務(wù)處理一個(gè)數(shù)據(jù)塊。
- Map階段:Map任務(wù)讀取其分配的數(shù)據(jù)塊,逐行處理,執(zhí)行用戶(hù)定義的Map函數(shù),生成中間鍵值對(duì)。
- Shuffle與Sort:Map任務(wù)的輸出被寫(xiě)入本地磁盤(pán),然后根據(jù)Key進(jìn)行分區(qū)和排序,通過(guò)網(wǎng)絡(luò)傳輸?shù)綄⒁獔?zhí)行Reduce任務(wù)的節(jié)點(diǎn)。
- Reduce階段:Reduce任務(wù)拉取所有Map任務(wù)中屬于自己分區(qū)的、已排序的中間數(shù)據(jù),執(zhí)行用戶(hù)定義的Reduce函數(shù),進(jìn)行最終的聚合計(jì)算。
- 結(jié)果輸出:Reduce任務(wù)的結(jié)果被寫(xiě)入HDFS,作為最終輸出文件。
四、超越 MapReduce:YARN 與現(xiàn)代生態(tài)
早期的Hadoop 1.x版本將資源管理與作業(yè)調(diào)度緊密耦合在MapReduce框架內(nèi),限制了集群的靈活性和對(duì)其他計(jì)算模型的支持。Hadoop 2.x引入了YARN(Yet Another Resource Negotiator),將資源管理功能從MapReduce中剝離出來(lái),成為一個(gè)獨(dú)立的通用資源管理層。
- YARN的作用:它使得Hadoop集群可以同時(shí)運(yùn)行多種計(jì)算框架,如MapReduce、Spark(內(nèi)存計(jì)算)、Flink(流處理)、Tez(DAG計(jì)算)等,真正將Hadoop從一個(gè)單一的計(jì)算系統(tǒng)升級(jí)為一個(gè)大數(shù)據(jù)操作系統(tǒng)。
五、Hadoop 數(shù)據(jù)處理的應(yīng)用與挑戰(zhàn)
應(yīng)用場(chǎng)景:
海量日志分析:分析網(wǎng)站點(diǎn)擊流、服務(wù)器日志,進(jìn)行用戶(hù)行為分析、異常檢測(cè)。
推薦系統(tǒng):基于用戶(hù)歷史行為數(shù)據(jù),進(jìn)行協(xié)同過(guò)濾等大規(guī)模計(jì)算,生成個(gè)性化推薦。
數(shù)據(jù)倉(cāng)庫(kù):構(gòu)建企業(yè)級(jí)數(shù)據(jù)倉(cāng)庫(kù)(如Apache Hive),進(jìn)行復(fù)雜的ETL(抽取、轉(zhuǎn)換、加載)和離線批處理分析。
文本挖掘與自然語(yǔ)言處理:處理大規(guī)模文本語(yǔ)料庫(kù),進(jìn)行詞頻統(tǒng)計(jì)、情感分析等。
面臨的挑戰(zhàn):
實(shí)時(shí)性不足:經(jīng)典的MapReduce基于磁盤(pán)I/O,適合離線批處理,但對(duì)實(shí)時(shí)或近實(shí)時(shí)查詢(xún)響應(yīng)較慢。
編程復(fù)雜度:直接編寫(xiě)MapReduce程序相對(duì)繁瑣,需要關(guān)注底層細(xì)節(jié)。
* 生態(tài)系統(tǒng)復(fù)雜性:Hadoop生態(tài)包含眾多組件(如Hive, HBase, Spark等),學(xué)習(xí)、選型和運(yùn)維成本較高。
###
Hadoop作為大數(shù)據(jù)處理的奠基者,其分布式存儲(chǔ)(HDFS)和批處理計(jì)算(MapReduce/YARN)思想深刻地影響了整個(gè)行業(yè)的發(fā)展。盡管在面對(duì)實(shí)時(shí)流計(jì)算等場(chǎng)景時(shí),出現(xiàn)了Spark、Flink等更高效的計(jì)算引擎,但Hadoop的核心存儲(chǔ)系統(tǒng)HDFS和資源管理框架YARN,仍然是許多大型企業(yè)大數(shù)據(jù)平臺(tái)的基石。理解Hadoop數(shù)據(jù)處理原理,是踏入大數(shù)據(jù)領(lǐng)域、構(gòu)建穩(wěn)定可靠的數(shù)據(jù)處理管線不可或缺的關(guān)鍵一步。